No se si habéis jugado al Little Alchemy, es un juego en el que partes con los 4 elementos (aire, agua, tierra, fuego) y tienes que ir combinándolos para obtener nuevas sustancias, materiales, cosas, … Algunas más predecibles que otras, por ejemplo si mezclas agua y tierra y obtienes barro.
Si ya lo conocías, es posible que sepas lo adictivo que puede ser ir combinando items. Imaginaros lo que me pareció la idea de tener uno infinito (que luego no es tan infinito). Para ello usa un LLM para ir creando las diferentes combinaciones. Podéis probarlo en este link. Y en este otro encontrareis el articulo del autor sobre sobre el juego.
Nosotros vamos a probar la parte del uso de los modelos de lenguaje como motor del juego, para ello vamos a usar ChatGPT y Google Gemini.
Vamos a usar prompts diferentes ya que ChatGPT parece entender mejor los ejemplos que Gemini, al que hay que indicarle el
ChatGPT:
Vamos a jugar a un juego, yo te doy dos elementos y tu me dices un tercero producido por la suma de esos dos, por ejemplo: (agua + fuego) = [vapor] (tierra + tierra) = [roca] (agua + tierra) = [barro] (motor + rueda) = [coche]
Gemini:
Vamos a jugar a un juego, yo te doy dos elementos entre paréntesis y tu me dices un tercero producido por la suma de esos dos entre corchetes, por ejemplo: (agua + fuego) = [vapor] (tierra + tierra) = [roca] (agua + tierra) = [barro] (motor + rueda) = [coche]
En este vídeo de mi canal de Youtube se pueden ver las pruebas realizadas:
Haz click para ver el vídeo en mi canal de Youtube
En resumen, ChatGPT resulta mas comedido en las repuestas lo cual en este caso como motor de juegos resulta mejor ya que facilita procesar las respuestas. Gemini da una gran cantidad de detalles lo cual se agradecería en el caso de ser una conversación pero no en el que se le ha pedido en el prompt.
El fine tuning vía proxy es útil cuando tenemos un modelo que: o es demasiado grande para poder entrenarlo o no tenemos acceso a él. Aunque hemos de tener acceso a los logits que calcula para cada token.
La solución a este problema es tomar un modelo más pequeño (el proxy) con el mismo vocabulario y entrenarlo.
Así tendríamos tres modelos: el grande, el pequeño sin entrenar y el pequeño entrenado.
Si pasamos el mismo prompt a los tres modelos obtendremos tres distribuciones diferentes para los tokens del modelo. Una para cada modelo.
Ahora tomamos los resultados de los dos modelos pequeños y calculamos sus diferencias para cada token. Ahora aplicamos esas diferencias a los tokens del modelo grande. Con estos nuevos logits podemos calcular las nuevas probabilidades de cada token usando softmax.
Puedes ver una explicación rápida en el siguiente short:
No se vosotros pero últimamente he estado viendo montón de anuncios, artículos y titulares que hablan del prompt engineering y parecen reducirlo a saber unos poco trucos. No digo que esos trucos no sean útiles para hacer buenos prompts, pero los prompts son solo una parte de todo lo que puedes configurar en un modelo del lenguaje para conseguir los resultados que deseas.
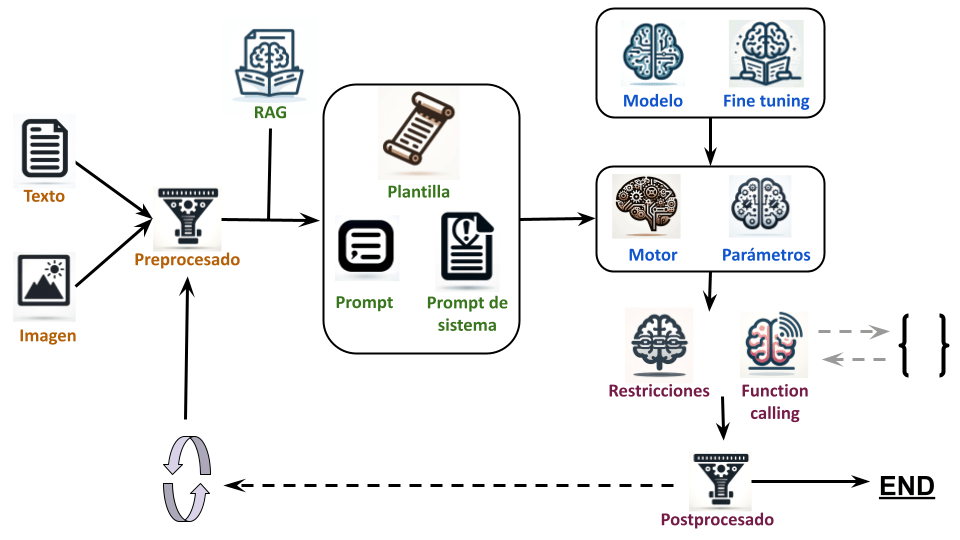
En la siguiente imagen se puede ver el proceso de funcionamiento de un modelo de lenguaje con cada una de las partes que se vamos a ver:
Elegir modelo y motor:
Elegir modelo: Para elegir el modelo necesitamos saber cuanta memoria VRAM tenemos (o podemos permitirnos). Como truco de calculo podemos aproximar que por cada parámetro el modelo ocupa 4 bytes (32 bits). Así que un modelo de 30B ocupa unos 120GB de memoria VRAM. Hay opciones como los modelos cuantizados, que bajan la precisión de cada parámetro. Por ejemplo si la bajas de 32 a 16 bits el modelo ocuparía la mitad. A cambio el modelo empeora. ¿Es mejor un modelo de 30B cuantizado a 4 bits, uno de 15B cuantizado a 8 bit, uno de 7B cuantizado a 16 bits o uno de 3,5B sin cuantizar? Todos ocupan casi lo mismo. Otra característica importante del modelo es para que está entrenado, básicamente puede estar entrenado para completar texto, seguir ordenes o chatear. Esto afecta a como va a interactuar con el usuario y como se van a escribir los prompts. Ademas es importante saber en que idiomas funciona el modelo y si ha sido entrenado o «finetuneado» con datos que necesitas, por ejemplo: un modelo entrenado para programar. No hay que olvidar la posibilidad de la multimodalidad (audio, voz, imágenes, vídeo, …)
Elegir motor: Una vez elegido el modelo habrá que elegir el motor para ejecutarlo. Dependerá básicamente de tres cosas: las características del modelo (familia y cuantización), de la API que necesitemos (servidor, librería, lenguaje de programación,…) y del hardware donde vaya a ejecutarse (GPU, CPU, RAM, VRAM)
Parámetros: Al ejecutar un modelo en el motor hay diferentes parámetros (dependen del motor y el modelo). Al configurarlos podemos obtener diversos resultados, un modelo más o menos original o coherente, variar las probabilidades de algunas palabras, sacrificar calidad por velocidad, …
Fine tuning: Si no se encuentra el modelo adecuado habrá que plantearse adaptar uno existente con fine tuning
Preprocesado
Preprocesado: Antes de enviar el texto al modelos habrá que tener en cuenta si es necesario procesarlo, cosas como: censurarlo, darle formato, traducirlo, …
Texto: Los datos en formato texto sobre los que vamos a trabajar
Multimedia: Si el modelo es multimodal no solo tendremos datos en forma de texto, también tendremos otro tipo de datos. Por supuesto habrá que preprocesar esos datos también.
Procesado:
RAG: Si queremos incluir documentos o información externa relacionada con el prompt podemos usar RAG. Para usar esta técnica tenemos que tomar varia decisiones: el algoritmo que se usa para elegir los documentos (puede ser necesario elegir otro modelo de lenguaje), el tamaño de los bloques que se van a elegir, como estos documentos se van a procesar para crear esos bloques, ….
Plantilla para el prompt: Hay que definir la plantilla que va a usar el modelo del lenguaje, vendrá definida por el entrenamiento y fine tuning del modelo de lenguaje.
Prompt de sistema: Aquí empieza ya la magia del prompt. Este es el prompt inicial que se le pasa al modelo describiendo su rol , comportamiento y funciones. Es importante definir lo correctamente
Restricciones: No tenia muy claro como llamar esta parte. Consiste en limitar la salida de texto a unas reglas definidas. Por ejemplo, usando expresiones regulares o gramáticas BNF. Sirve para obligar a que la respuesta tenga un formato concreto.
Function calling: Al modelo se le pueden pasar la descripción y firma de diversas funciones de código y, si esta entrenado para ello, puede invocarlas eligiendo los parámetros para las mismas.
Prompt: ¡Por fin! Aquí está el famoso prompt, el texto del prompt ha de integrar los demás datos y funcionalidades, describir correctamente lo que deseamos que el modelo de lenguaje haga. En muchos casos el prompt tiene varios pasos y es necesario pasar varias veces por el LLM para procesarlo.
Postprocesado:
Postprocesado: Una vez generado el texto será necesario procesar la respuesta.
Iteraciones extras: Hay flujos de trabajo que se dividen en varias iteraciones o pasos, sigues alguno de estos es posible que tengas que plantearte modelos para los siguientes pasos o
Function calling: Si se determina que hay que llamar a alguna función, este es el punto donde se le llama y se procesa la respuesta.
Es te flujo ha de considerarse un resumen simplificado. Hay más opciones y técnicas, pero aqui se recogen prácticamente las mínimas a usar hoy en día.
¿Y por qué te has centrado en modelos de lenguaje y no otras IA generativas que usan prompts como las que generan imágenes? Por que los modelos de lenguaje son sencillos. Por ejemplo, Stable Difussion tiene tantas formas de alterar su funcionamiento y resultados que no se si seria capaz de citar las más usadas.
Puedes ver un vídeo explicativo en mi canal de Youtube:
Haz click para ver el vídeo en mi canal de Youtube
Es frustrante cuando usamos un LLM para realizar una tarea, estamos comprobando el resultado y tras un par de párrafos que tienen muy buen aspecto el texto da un giro inesperado y empieza a inventarse cosas. En este caso decimos que el modelo alucina. Pero no es el único caso de alucinación, cuando genera contradicciones en el texto o pierde el hilo de lo que ha escrito también está alucinando.
En los casos más graves puede generar texto sin ningún sentido. Sin embargo, los casos más peligrosos son aquellos en que la respuesta parece correcta pero no lo es. De hecho, muchas veces, los modelos de lenguaje son bastante buenos argumentando en favor de la respuesta que han dado.
Entonces ¿Qué es una alucinación? No está claro, depende del modelo, del contexto y del prompt. Si por ejemplo a un modelo entrenado para tener censura sobre ciertos temas nos responde con la receta de una bomba está alucinando, pero para un modelo sin cesura es correcto, a no ser que en mitad de la receta empiece a usar cacao, harina y huevos.
Un punto a tener claro es que una alucinación NO ES el un mal funcionamiento del sistema, es el funcionamiento normal del mismo, por eso es tan difícil saber cuando el modelo está generando alucinaciones, ya que funcionalmente es idéntico a cuando no las produce
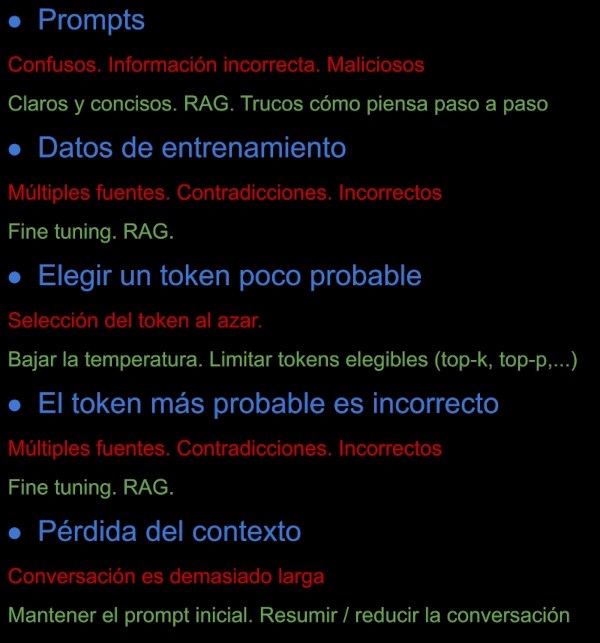
Hay cuatro (se que abajo veis cinco puntos, no es un error) principales causas de las alucinaciones,vamos a verlas junto con las técnicas para reducirlas:
Prompts: Los prompts confusos, que introduzcan información errónea o directamente malintencionados pueden ser la causa de las alucinaciones. No tiene porque ser prompts incorrectos de forma intencionada. La mejor opción para evitar estas alucinaciones es repasar los prompts y tratar de ser cuidadoso y claro en la redacción de los mismos. Y tratar de no añadir información que no sea completamente cierta. Otros «trucos» que suelen funcionar es pedirle que razone paso a paso o hacerle chantaje emocional (¡En serio!) diciéndole que es muy importante que lo haga correctamente o proprias perder el trabajo (repito: es en serio)
Datos de entrenamiento: los modelos de lenguaje están entrenados con datos de diversas fuentes, por lo que entre ellas se pueden producir contradicciones o directamente contener datos incorrectos. Las dos principales opciones para reducir estás alucinaciones son el fine tuning con datos adecuados o complementar el prompt con información más concreta (por ejemplo usando RAG)
Elegir un token poco probable: una vez el modelo ha calculado las probabilidades de los «siguientes tokens» se realiza una selección aleatoria de uno de ellos, puede ser que alguna vez se elija un token con pocas probabilidades de ser elegido y eso haga que la predicción de tokens «pierda el rumbo». Es lo que suele pasar cuando subimos el parámetro «temperatura». Depende el programa que usas para ejecutar el LLM tendrás diversos parámetros como top-K, top-P, min-P o la temperatura que permite acotar la probabilidad de los tokens validos para ser elegidos.
El token más probable es incorrecto: Este caso podríamos agruparlo dentro del de datos de entrenamiento, pero lo pongo aqui separado para distinguirlo del anterior. Ya que no es que se elija un token poco probable, es que los más probables son incorrectos. La solución es la misma que en el caso de los datos de entrenamiento.
Pérdida del contexto: los modelos tienen un tamaño de contexto. Cuando la conversación se alarga y sobrepasa este tamaño se pierde información lo que puede hacer que el modelo pierda «el tema de la conversación». Casi todos los programas para ejecutar LLM traen alguna solución para conservar el prompt inicial o parte del mismo. De todas formas es recomendable tratar de mantener la conversación lo más corta posible.
Os aviso que estas soluciones no son milagrosas, que aun usándolas no se van a resolver todos los problemas de alucinaciones.
Puedes ver el vídeo en mi canal de Youtube con ejemplos:
Haz click para ver el vídeo en mi canal de Youtube
¿Cómo podemos obtener el prompt que genera una imagen concreta? No podemos. Ha sido un post breve…Para empezar no es sencillo desandar el camino de la imagen hasta el prompt. Una imagen tiene muchísima información que puede o no haber sido detallada en el prompt. Si el protagonista de la imagen sonríe…¿ha sido especificado en el prompt?. Una palabra más y el resultado cambia. Pero es que aunque tuvieras el prompt exacto que usó el creador (mirando por encima de su hombro cuando lo escribió, por ejemplo) haría falta la semilla exacta para obtener la misma imagen.
¿Entonces qué podemos hacer?. Podemos obtener un prompt inspirado en una imagen que nos gusta.
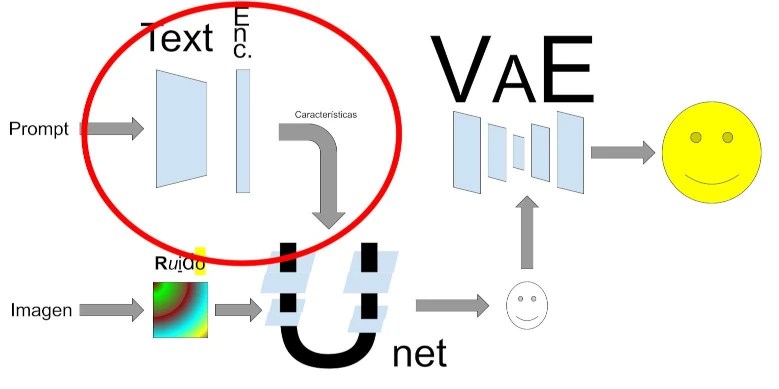
Vamos a empezar por las bases: CLIP. Debajo podemos ver un esquema que resume la arquitectura de Stable Diffussion, en un círculo rojo podemos ver de qué parte se ocupa CLIP.
CLIP actúa como puente entre el lenguaje escrito y las imágenes, transforma el prompt en características de la imagen. También funciona pasándole una imagen, extrae sus características. “¡Ya está!” Le pasamos la imagen y vemos qué palabras corresponden con ella…desgraciadamente aquí es donde surge otro problema. No hay una relación exacta entre las palabras y las imágenes. Ambos se codifican como vectores y se toma el más cercano, sin embargo esto puede dar lugar a que se elijan combinaciones de palabras que no son tan buenas describiendo la imagen.
En la imagen podemos ver un ejemplo donde la combinación de palabras: “RUEDAS FARO ROJO” está más próxima a la imagen del coche que “COCHE”.
Con esta información ya podemos hacernos una idea de como funcionan estos sistemas, van probando diferentes combinaciones de palabras. Desde el algoritmo más simple que usar varias listas de palabras e ir combinándolas para crear frases. por ejemplo un listado de objetos, colores, planos, artistas, estilos, ….. Hasta algoritmos más complejos como PEZ.
Vamos a probar dos herramientas con la siguiente imagen:
Veamos que prompts generan y cual es el resultado si usamos esos prompts para generar unas cuantas imágenes.
cartoon robot writing in front of easel with cityscape in background, icon for an ai app, he is holding a large book, delete duplicating content, studyng in bedroom, a painting of white silver, image of random arts, textbook page, 2019, future coder, retro coloring
Sin embargo hay una opción más, usar un modelo multimodal (como LLaVA que es el que usaremos en este post) para que te describa la imagen. Podemos usar el prompt:
Describe the image
Nos da una descripción pero no es lo que queremos. No faltan datos sobre composición, habrá que pedirselos:
Describe the image in detail: subject, composition, color, type of lens, setting, similar famous artists
El resultado es el que queremos
Tell me what type of art the image is in a few words in no more than 20 words
Describe the art style in the image in few words in no more than 20 words
Describe the artistic composition of the image in no more than 20 words
Describe the type of lens use in the image
Describe the kind of color in the image
Describe the photo in few words
Describe the sensations conveyed by the image in few words
Tell me the name of a famous artist whose work is similar to the one in the image. Respond with name only
Juntando todos las respuestas (omitiendo las repetidas):
Robot painting. Fisheye Lens. Cartoon. A robot is standing in a room, holding a pencil and looking at a book. The room has a painting on the wall and a window. The robot is surrounded by several books, some of which are stacked on the floor. Leonardo da Vinci
Puedes ver el proceso en vídeo en mi canal de Youtube:
Haz click para ver el vídeo en mi canal de Youtube
Cuando aparecieron los primeros modelos de texto a imagen requerían un hardware potente y mucha paciencia para obtener resultados que en esa época eran sorprendentes (actualmente los consideraríamos como «malos resultados»). Esos primeros modelos basados en VQGAN requerían varios minutos usando hardware potente, Google Colab mediante, para lograr generar una imagen. Con los modelos de difusión la cosa mejoró, sin embargo seguíamos necesitando GPUs con gran cantidad de memoria RAM. Pero la comunidad de software libre está haciendo un gran esfuerzo por lograr que se ejecute en hardware cada vez más modesto.
¿Hasta qué punto se ha optimizado Stable Diffusion? ¿Podemos usarlo en un ordenador normalito?.
Primero, uso Stable Diffusion porque al ser código libre ha permitido a la gente «trastear» con él, ventajas del Open Source.
Al empezar a mirar opciones he descubierto que hay muchísimos proyectos que tratan de reducir los recursos necesarios para ejecutar SD. Al final me he decantado por el proyecto stable-diffusion.cpp por los siguientes motivos:
Es un proyecto real que trata de hacer SD usable con muchas de sus características. Muchos de los otros proyectos son poco más que demos técnicas muy limitadas.
Esta en continuo desarrollo.
Busca un equilibrio entre consumo de recursos y usabilidad.
Antes de empezar con las pruebas hemos de entender cómo funciona SD. Para ello usaremos el siguiente esquema:
SD consta principalmente de tres partes:
Text Encoder: convierte el prompt en embeddings que usa para condicionar el funcionamiento de la Unet
Unet: es alimentada con una imagen llena de ruido y su trabajo es eliminarlo, condicionado por el text encoder, para obtener la imagen. En este paso SD no trabaja con la imagen final si no con una descripción en el espacio latente de la misma
V.A.E.: su función es convertir la descripción del paso anterior en una imagen.
Este es el funcionamiento para generar una imagen a partir de un prompt. Si queremos generarla cuando una imagen de partida, además del prompt, lo que se hace es que en lugar de pasar a la Unet una imagen llena de ruido se le pasa la imagen de partida y se le añade ruido. De esta manera la imagen influirá sobre el resultado final.
Sabiendo esto vamos a ver que «trucos» usa stable-diffusion.cpp para conseguir optimizar la ejcución de SD:
Esta programado en C++ buscando exprimir al máximo el rendimiento del programa
Usa un versión cuantizada del modelo. En mis pruebas usar la versión Q4_1 que usa unos 4 bits por parámetro. Mientras que el modelo original usa 32 bits.
Usar la versión mini y nano de SD que generan imágenes mas pequeñas. Este truco lo añado yo después de verlo comentado en el proyecto.
Tenéis un vídeo con detalles de la pruebas y de la tabla de resultados en mi canal de Youtube:
Haz click para ver el vídeo en mi canal de Youtube
./bin/sd -m [modelo] -H 768 -W 768 -p «A sheep with sunglasses riding a motorbike»
Se ha probado con diferentes tamaños de imagen según el modelo empleado:
Modelo
Dim.
Clip
Unet
VAE
Mem.
Tiempo
1.4 – Q4_1
512
73.80/87.21
1286.35/1857.94
94.51/1768.95
1952.45
199.92
1.5 – Q4_1
512
73.80/87.21
1286.35/1857.94
94.51/1768.95
1952.45
218.39
2.1 nano – Q4_1
512
211.55/226.21
1290.15/1669.82
94.51/1768.95
1768.65
254.42
2.1 – Q4_1
512
211.55/226.21
1290.15/1669.82
94.51/1768.95
1768.65
179.76
2.1 – Q4_1
768
211.55/226.21
1290.15/3021.54
94.51/3848.65
3848.65
543.88
1.4 mini – Q4_1
256
73.80/87.21
1286.35/1346.94
94.51/520.65
1468.07
57.44
2.1 nano – Q4_1
128
211.55/226.21
1290.15/1314.91
94.51/208.65
1610.88
15.62
2.1 – f32
512
1346.65/1360.93
2179.92/2553.33
94.51/1768.65
3653.36
181.84
2.1 – f32
768
1346.65/1360.93
2179.92/3897.24
94.51/3848.65
3991.75
566.58
Mem., Clip, Unet y VAE indican el tamaño en MB Clip, Unet y VAE indican el tamaño de: parámetros / total memoria en ejecución Dim. indica el tamaño en pixeles de la imagen Dim x Dim Tiempo indica la duración de la creación en segundos
Las pruebas han sido realizadas en un portátil con un procesador AMD Ryzen 7 5800H con 16 GB de memoria RAM.
Como mención honorifica cabe destacar otro proyecto: OnnxStream que logra ejecutar SD en una Raspberry Pi 2 Zero que solo tiene 512MB (¡Y le sobran casi 200 MB!) de memoria RAM
Últimamente se habla mucho del uso de bases de datos vectoriales combinadas con grandes modelos de lenguaje. ¿Pero que relación tienen?. El punto en común entre ambos son los embeddings. ¿Qué es un embedding?. Un embedding es un vector que representa la descripción del significado de un texto (en este caso) en un espacio de múltiples dimensiones. Este espacio establece una relación entre los diversos significados de los textos, de tal forma que el angulo formado por dos vectores indica lo próximos que sus significados están.
Para calcular lo parecidos que son dos vectores usaremos la similitud coseno (cos_sim): u ⋅ v /∣u∣∣v∣ Siendo u y v vectores. 1 significa que son idénticos, 0 que no tienen relación y -1 que son contrarios.
Los embeddings son usados en los modelos de lenguaje para representar el texto de forma interna y trabajar con él en forma de vectores (no confundir con los wordvectors, aunque la idea es la misma y están relacionados los wordvectors funcionan a nivel de token…si no sabes lo que es un token quédate con que funcionan a nivel de palabra).
Para estas pruebas usaremos el modelo de lenguaje BERT a través de la librería sentence-transformers.
Primero cargamos las librerías que necesitamos y el modelo
import numpy as np
from sentence_transformers import SentenceTransformer, util

#Cargamos el modelo
sbert_model = SentenceTransformer('all-mpnet-base-v2')
Estas son las sentencias con las que vamos a comparar nuestro texto de búsqueda. Las sentencias han sido obtenidas de la Wikipedia en inglés, en concreto la primera del articulo de mecánica cuántica y las siguientes de la definición de física clásica.
sentences = [
    "a fundamental theory in physics that provides a description of the physical properties of nature at the scale of atoms and subatomic particles.",
    "refers to theories of physics that do not use the quantisation paradigm, which includes classical mechanics and relativity.",
    "physical objects ranging from those larger than atoms and molecules, to objects in the macroscopic and astronomical realm",
    "in the context of general and special relativity, classical theories are those that obey Galilean relativity."
]
Buscamos *Quantum mechanics*, deberia de dar como mayor similitud el primer texto. Fijaros en la trampa de que el segundo incluye *quantisation paradigm* para «engañar» al modelo y ver si es capaz de buscar por «significado» y no solo por «similitud de las palabras»
Una pequeña optimización que se puede hacer si vas a almacenar estos vectores para compararlos varias veces. Podemos normalizar los vectores, esto significa que le damos longitud uno sin modificar la dirección del mismo, podemos usar el producto escalar (dot_score), mucho más rápido que la similitud coseno.
Si partimos de la similitud coseno u ⋅ v /∣u∣∣v∣ Al tener distancia 1 los módulos || son 1 por lo que el divisor desaparece y queda solo el producto escalar u ⋅ v
¿Pero que tiene esto que ver con las bases e datos vectorariales?. Una base de datos vectorial funciona básicamente como el ejemplo (en realidad usa diferentes operaciones especializadas para diversos casos). Asocia un vector con los datos originales a los que representa y permite buscar a partir de un texto, que es convertido en embedding.
Lo bueno de los embeddings es que no solo puede representar texto, usando modelos multimodales se pueden usar embeddings que provengan de imágenes, audios, vídeos, … Lo que permite cruzar datos heterogéneos.
Esta flexibilidad hace que muchas veces puedan cumplir funciones como búsqueda inteligente de textos, responder preguntas, buscar referencias o datos relacionados que a su vez se pueden combinar con los modelos de lenguaje aportando estos datos al contexto del mismo. Un ejemplo de este eso es su uso en técnicas como RAG descrito en esta entrada del blog
Puedes ver todo esto descrito en el siguiente vídeo de mi canal de Youtube:
En este post vamos a usar audiocraft la IAs que ha publicado Meta centradas en generar sonidos y música a partir de descripciones de texto (prompts). Para ello usaremos el código publicado por Meta en su repositorio público de Github
Audiogen
Esta IA sirve para generar sonidos a partir de una descripción de los mismos.
En este caso solo disponemos de un modelo:
facebook/audiogen-medium: 1.5B texto a audio
Para esta IA vamos a usar un colab propio creado a partir del README de su repositorio.
En el siguiente vídeo de mi canal de Youtube están descritos los pasos para usarlo:
Haz click para ver el vídeo en mi canal de Youtube
Musicgen
Musicgen permite crear música de dos formas: a partir de una descripción en texto y además de la descripción usando una melodía como base (solo con el modelo musicgen-melody).
En este caso la demo está mucho más trabajada que en el caso anterior y cuanta con una completa interfaz gráfica que permite probar las diferentes opciones. Usaremos el colab que viene incluido en el README de su repositorio.
Contamos con 4 modelos diferentes:
facebook/musicgen-small: 300M, texto a música facebook/musicgen-medium: 1.5B, texto a música facebook/musicgen-melody: 1.5B, texto a música y texto+melodia a música facebook/musicgen-large: 3.3B, texto a música
En el siguiente vídeo de mi canal de Youtube están descritos los pasos para usarlo:
Haz click para ver el vídeo en mi canal de Youtube
Cuando empiezas a trastear con los LLM descubres que se pueden configurar diversos parámetros, por desgracia su significado y utilidad muchas veces no esta muy claro, para solucionar eso voy a tratar de explicar los distintos parámetros que se pueden configurar habitualmente en los LLM. Mi intención no es dar una explicación detallada de como funciona cada uno, sino explicar de forma intuitiva su uso. He usado el nombre (o nombres) en inglés más habituales, aunque es posible que se llamen de forma un poco diferente según la librería que uses para ejecutar los modelos. Igualmente, cuales se pueden usar depende de la librería y del modelo de lenguaje que uses. Al final puedes encontrar un vídeo con una explicación más detallada de los parámetros más importantes. Empecemos:
Prompt Template: Establece la plantilla que se usara en la conversación con un cahtbot. En ella se indicara donde se inserta el prompt del usuario. Es importante usar la plantilla adecuada para el modelo de LLM que usamos. en algunos casos la plantilla esta dividida en prefix (prefijo) y (sufix) sufijo.
System Prompt: Es el prompt inicial que se le pasa al LLM en el se le indica como que tiene que hacer.
Context Size: indica el tamaño del contexto en tokens. Es la cantidad de tokens con la que el modelo puede trabajar.
Prompt Batch Size: Es una técnica de optimizan que divide el prompt en bloques del tamaño indicado para alimentar el LLM. Un tamaño demasiado pequeño puede afectar a la calidad del resultado
RoPE-scaling (rotary position embeddings scaling): se refiere a una técnica para aumentar el tamaño del contexto. Indica por cuánto se multiplica el tamaño del mismo.
Number of Tokens to Predict: Números de tokens a generar. ¡Ojo! Eso no quiere decir que la respuesta vaya a tener ese número exacto de tokens. Es posible que sea menor ya que existe un token End-of-Sequence (EOS) que indica que el texto termina ahí. Algunos modelos permiten ignorar este token, aunque no se garantiza que el texto que siga tenga demasiado sentido.
Temperature: Controla «lo aleatorio» que es el proceso para elegir la siguiente palabra. A mayor valor más «creativo» será el texto generado. Si su valor es 0 elegirá siempre el token más probable mientras que valores mayores hará que pueda elegir entre otros tokens menos probables. Se puede usar para equilibrar la coherencia y la creatividad.
Repeat penalty / Presence penalty/ Frequency Penalty: se utiliza para evitar que el modelo repita las mismas palabras con demasiada frecuencia en el texto generado. Es un valor que se resta a la probabilidad de elegir un token cada vez que ocurre en el texto generado. Un valor elevado hará que el modelo sea menos propenso a repetir tokens. La diferencia entre presence y frequency es que el primero solo valora si el token está o no, frecuency acumula valor por cada vez que aparece el token En algunos modelos se pueden usar número negativos para conseguir el efecto contrario. Suele tener otro parámetro para indicar cuántos de los últimos tokens se tienen en cuenta.
Top K Sampling: es un método que selecciona el siguiente token de de un subconjunto formado por los k tokens más probables. A menor valor tenga más predecible será el texto generado.
Top P Sampling: similar a Top K, con la diferencia de que selecciona el siguiente token de un subconjunto de tokens que juntos tienen una probabilidad acumulada de al menos p.
Tail Free Sampling (TFS): La misma idea que Top P pero más refinada intenta no meter tokens con muy baja probabilidad dentro del subconjunto del tokens entre lo que se elige el siguiente. Su valor es entre 0 y 1. Si el valor es 1, TFS no influye en el resultado (podríamos decir que esta desactivado). Lo habitual son valores entre 0.9 y 0.95.
Classifier-Free Guidance (CFG): Es una técnica, que proviene de los mecanismos de difusión usados en la generación de imágenes, para ayudar a mantener el contenido generado próximo al prompt. En este caso se usa un contexto para guiar la generación, suele ser la última palabra del prompt o el System promtp. También permite prompts negativos con los LLMs
Logit Bias: Permite aumentar/disminuir la probabilidad de ciertos tokens.
RNG Seed / Seed: Establece la semilla con la que se inicializa el generador de números aleatorios. Permite obtener resultados repetibles usando la misma semilla.
Puede ver esto mismo explicado en vídeo haciendo click en la imagen:
Haz click para ver el vídeo en mi canal de Youtube
Investigando sobre Bark, proyecto del que ya hemos hablado en este blog. Descubrí que hay un proyecto que permite clonar voces para usarlas en Bark.
La idea me entusiasmo, sin embargo surgió un problema, no había un modelo en español sobre el que clonar mi voz. Resumiendo mucho, cuando «clonas» una voz a partir de un breve audio lo que hace el programa es extraer las características de tu voz y aplicarlas a un modelo ya existente. Por eso el resultado de «clonar» es tan dispar según la voz que se trate de replicar. Al no tener un modelo es español tuve que usar uno en inglés, el resultado es una voz inglesa pero «que suena» como la mía.
El proyecto original tiene una notebook en python para ejecutar: clone_voice.ipynb. Está pensado para ejecutarlo en local. Más adelante explico que pasos hacer para ejecutar ese notebook en VSC. Pero he creado una versión que se ejecuta en Google Colab, lo puedes encontrar aqui.
Consejos para grabar tu voz
Es necesario crear un pequeño fichero audio.wav del que poder clonar la voz.
Audios de no más de 13 segundos
Formato .wav PCM 16 bits (a mí me ha funcionado, es posible que acepte más)
Lo recomendado son 9 – 10 segundos
Habla claro, tranquilo y vocaliza bien
Reduce, en lo posible, los ruidos de fondo
Que no haya más de una voz en el audio
Puedes ver un ejemplo de como usar el Google Colab en el siguiente vídeo de mi canal de Youtube:
Haz click para ver el vídeo en mi canal de Youtube
Instalar y ejecutar en local
Veamos los pasos para instalarlo en local
git clone https://github.com/serp-ai/bark-with-voice-clone.git
cd bark-with-voice-clone
pip install git+https://github.com/suno-ai/bark.git
git clone https://github.com/gitmylo/bark-voice-cloning-HuBERT-quantizer/
cd bark-voice-cloning-HuBERT-quantizer
pip install -r requirements.txt
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu117
cd ..
Para clonar una voz debemos usar el cuaderno de Python: clone_voice.ipynb Que se encuentra en el directorio raíz del proyecto.
Si no sabes como ejecutarlo puedes usar Visual Studio Code, el propio IDE te sugerirá que plugins necesitas instalar para ejecutarlo.
Si tienes una tarjeta gráfica que no sea de NVIDIA, que no soporte CUDA o que tenga menos de 12Gb de VRAM puedes ejecutarlo usando exclusivamente CPU (debes disponer de 12 Gb de memoria RAM libres). Para que todo funcione usando la CPU debes cambiar la siguiente línea:
#device = 'cuda' # or 'cpu'
device = 'cpu'
Debo avisar que ejecutarlos sobre CPU hace que tarde unas dos horas (portátil con AMD Ryzen 7 – 50xx) durante las cuales el ventilador hace ruido de que quiere despegar.